LLM이 생성하는 스파게티 코드를 해결하는 간단한 방법, 프로젝트 루트에 agent.md 두기
LLM이 생성하는 스파게티 코드를 해결하는 간단한 방법, 프로젝트 루트에 agent.md 두기
GeekNews · 2026-08-24 05:32
① 2026년 LLM은 복잡한 버그도 잡아내지만, 주석과 구조가 없는 스파게티 코드를 생성하는 한계가 있습니다.
② 매 세션마다 반복하던 코드 스타일 지침을 agent.md 파일에 적어 프롬프트에 자동 주입해 문제를 해결합니다.
③ 상수화, 이른 반환, 접근 제한 유지, 7가지 Git 커밋 규칙 등 구체적인 지침을 에이전트 파일에 명시합니다.
④ 버그 수정 요청 시 코드를 바로 고치지 않고 실패하는 테스트 코드부터 작성하도록 강제합니다.
⑤ 컨텍스트가 길어지면 지침을 잊는 문맥 희석 현상이 발생하므로, 새 세션을 시작하거나 주기적으로 다시 로드해야 합니다.
LLM 코딩의 진화와 스파게티 코드라는 새로운 걸림돌은 무엇인가요?
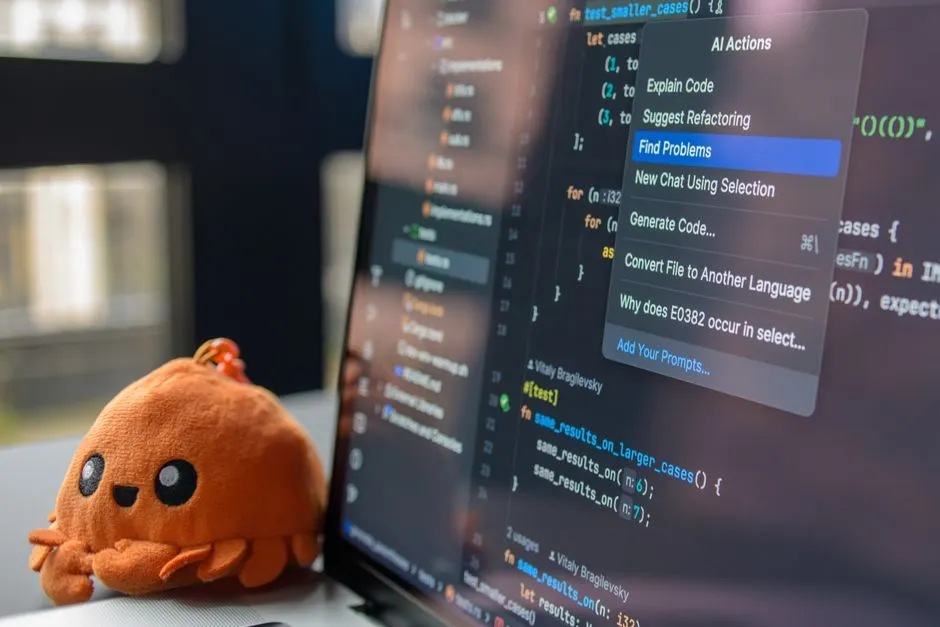
인공지능의 코드 생성 능력은 빠르게 발전하고 있습니다. 2025년 중반에 러스트(Rust, 시스템 프로그래밍 언어) 기반의 mDNS 구현체인 'libadbmdns' 개발에 LLM을 처음 도입했을 때는 생성된 코드가 컴파일조차 되지 않는 수준이었습니다. 하지만 2026년 1월에 이르러서는 복잡한 인덱스 바이너리 힙(indexed-binary heap) 클래스를 직접 작성하고, 윈도우 IOCP(Input/Output Completion Port, 입력과 출력을 비동기적으로 처리하는 윈도우 커널 객체) 구현에서 발생한 까다로운 버그까지 스스로 찾아낼 정도로 성능이 향상되었습니다.
그러나 기능 구현 능력의 비약적인 상승과 별개로 새로운 문제가 나타났습니다. LLM이 작성해 준 결과물은 주석이 전혀 없고 구조도 엉망인 스파게티 코드(구조가 복잡하게 얽혀 읽기 힘든 코드) 형태인 경우가 많았습니다. 인공지능 덕분에 코드를 빠르게 작성하더라도, 이를 프로덕션(실제 서비스 운영 환경) 수준으로 정리하고 다듬는 데 너무 많은 시간이 소요되어 결과적으로 개발 속도 향상이라는 이점이 상쇄되는 한계에 부딪혔습니다.
반복되는 코드 리뷰 지침을 자동화하는 agent.md란 무엇인가요?
에이전트 기능이 내장된 IDE(integrated development environment, 통합 개발 환경) 환경을 사용하면서 개발자는 코드에 대해 반복적인 피드백을 주기 시작했습니다. "매직 넘버를 사용하지 마라", "의도를 설명하는 짧은 주석을 추가해라", "함수 이름을 더 짧게 만들어라" 같은 잔소리를 끊임없이 반복해야 했습니다. 이러한 피드백 과정을 여러 번 거치면 코드 품질이 사람이 직접 짠 것처럼 훌륭해졌지만, 새로운 대화 세션을 시작할 때마다 똑같은 지시를 매번 다시 입력해야 하는 번거로움이 있었습니다.
이 문제를 해결하기 위해 고안된 방법이 바로 프로젝트 루트 폴더에 'agent.md' 파일을 배치하는 것입니다. 코딩 하네스(coding harness, 코딩을 보조하고 실행하는 에이전트 시스템)가 세션을 시작할 때 이 파일을 자동으로 읽어 프롬프트(prompt, 인공지능 모델에 제공하는 지시문)에 주입하는 방식을 활용하는 것입니다. 개발자는 여러 도구에서 범용적으로 쓸 수 있도록 gemini.md나 claude.md 파일을 agent.md 파일에 심볼릭 링크(symbolic link, 특정 파일을 가리키는 가상 파일)로 연결해 두고, 새로운 규칙이 필요할 때마다 에이전트에게 이 파일을 직접 업데이트하도록 요청하며 지침을 관리합니다.
agent.md에 정의해 두어야 하는 구체적인 코드 작성 규칙은 무엇인가요?
프로젝트 스타일에 맞춰 agent.md 파일에 명확한 기술적 규칙들을 명시하면 코드 품질을 극적으로 제어할 수 있습니다. 예를 들어 가독성과 유지보수성을 높이기 위해 매직 넘버(의미를 알 수 없는 상숫값)와 고정된 문자열은 설명적인 상수나 열거형(enum)으로 추출하도록 규정합니다. 단, 자명한 일회성 값은 불필요한 복잡성을 방지하기 위해 코드 내에 그대로 두며, 명세에서 정의된 값은 예외 없이 상수를 쓰도록 지시합니다.
가독성과 안정성을 높이는 핵심 코딩 규칙
- 이른 반환(early return) 활용: 중첩된 들여쓰기를 줄여 Arrow Anti-Pattern(화살표 모양으로 코드가 깊게 들여써지는 현상)을 방지합니다.
- 함수 이름 제약: 직관성을 위해 함수의 이름은 항상 30자 미만으로 제한합니다.
- 불리언 대신 열거형 사용: 함수의 매개변수로 True/False를 직접 넘기기보다 명확한 enum을 활용합니다.
- 엄격한 블록 구문: 한 줄짜리 if 문이라 할지라도 항상 중괄호({})를 생략하지 않고 작성합니다.
또한 논리적인 코드 블록 사이에는 빈 줄을 삽입해 시각적 여백을 주고, 블록의 역할과 목적을 명시하는 짧고 직관적인 주석을 반드시 달도록 강제합니다. 복잡한 설계를 설명해야 할 때는 텍스트 대신 아스키 아트(ASCII art, 문자들을 조합해 만드는 그림)를 제안하게 만드는 것도 유용한 팁입니다.
설계 아키텍처와 경계를 보호하기 위한 지침은 어떻게 작성하나요?
LLM은 종종 작업 범위를 벗어나 시스템 전체의 결합도를 높이는 무분별한 수정을 가하기도 합니다. 이를 막으려면 접근 제어와 레이어드 아키텍처(layered architecture, 계층형 구조 설계) 경계를 보호하는 엄격한 제약 조건을 적어두어야 합니다. 클래스 멤버의 가시성을 변경하는 행위는 설계 아키텍처를 뒤흔드는 중대한 변화이므로, 외부 접근이 확실하게 필요한 상황이 아니라면 모든 필드와 함수를 프라이빗(private, 클래스 내부에서만 접근 가능한 제한자) 상태로 유지하도록 명시합니다. 접근 제한자를 확장해야 할 때는 반드시 사전에 개발자의 승인을 받게 만듭니다.
동시에 각 계층은 인접한 하위 계층과만 통신하도록 지침을 내립니다. 사용자 인터페이스나 컨트롤러가 하위 데이터베이스 쿼리나 네트워크 클라이언트, 드라이버를 직접 호출하며 아키텍처를 우회하는 현상을 원천 차단하는 것입니다. 구현하고자 하는 기능과 무관한 다른 코드 블록은 일절 건드리지 못하게 지시하여 불필요한 코드 변경 줄 수를 최소화하고 사이드 이펙트(side effect, 의도치 않은 부작용)를 방지하는 것이 프로덕션 코드 품질 관리에 핵심적입니다.
품질을 극대화하는 버그 수정 방식과 커밋 메시지 규칙은 무엇인가요?
버그를 수정할 때 LLM이 무턱대고 코드부터 고치다가 더 큰 오류를 만드는 경우가 잦습니다. 이를 방지하기 위해 버그 수정 요청이 오면 수정 작업에 들어가기 전에 무조건 '실패하는 테스트 코드'부터 작성하도록 순서를 고정합니다. 테스트가 실제로 실패하는 것을 먼저 확인한 뒤에 코드를 수정하고, 다시 동일한 테스트를 구동하여 성공 여부를 검증하게 만드는 일종의 TDD(test-driven development, 테스트 주도 개발) 워크플로를 주입하는 것입니다.
수정이 끝난 후 생성되는 깃(Git) 커밋 메시지의 형식도 아래와 같은 7가지 원칙으로 규격화하여 프로젝트 관리 이력을 일관되게 유지합니다.
일관된 이력 관리를 위한 커밋 메시지 7대 원칙
- 제목과 본문 사이에 반드시 빈 줄 하나를 둘 것
- 제목은 영문 기준 50자 이내(절대 상한선은 72자)로 제한할 것
- 제목의 첫 글자는 항상 대문자로 시작할 것
- 제목 끝에 마침표(.)를 찍지 말 것
- 제목은 "If applied, this commit will..." 문장에 이어지도록 명령형 어조로 작성할 것
- 터미널 가독성을 위해 본문 텍스트는 72자마다 수동으로 줄바꿈을 처리할 것
- 코드가 해결한 기술적 방법론보다 '무엇을, 왜 변경했는지' 맥락 중심으로 기록할 것
컨텍스트가 길어질 때 발생하는 '문맥 희석' 현상은 어떻게 대처하나요?
프로젝트 루트에 agent.md 파일을 두는 방식이 생성 코드의 완성도를 크게 끌어올려 주지만, 이것이 개발자의 코드 리뷰 과정을 완전히 생략해도 된다는 뜻은 아닙니다. 인공지능 모델은 언제든 그럴듯한 거짓말을 지어내는 환각(hallucination)을 일으킬 수 있으므로, 최종 검증과 검토는 여전히 사람이 직접 수행해야 합니다. 다만 코드의 스타일이나 단순한 가독성 수준의 자잘한 피드백에 낭비되던 리소스를 줄여, 아키텍처의 설계나 비즈니스 로직의 적절성 같은 고차원적인 검토에 더 많은 시간을 투자할 수 있게 된다는 것이 핵심입니다.
또한 대화가 길어질수록 모델이 대화 중간에 위치한 프롬프트 지침보다 맨 처음이나 맨 마지막에 입력된 정보에 더 집중하는 '문맥 희석(context dilution)' 현상이 발생합니다. 아직 학계에서도 원인이 명확히 검증되지 않은 이 문제를 예방하기 위해서는 대화 흐름을 의도적으로 짧게 유지해야 합니다. 즉, 하나의 기능 구현 작업이 완료될 때마다 아예 새로운 대화 세션을 시작하는 습관을 들이는 것이 좋습니다. 대화 도중 모델의 코드 품질이 눈에 띄게 떨어진다고 느껴진다면 망설이지 말고 에이전트 시스템에 "Reload agent.md"라고 명령하여 규칙 파일의 지침을 다시 한번 환기시켜 줄 필요가 있습니다.


댓글
댓글 쓰기